
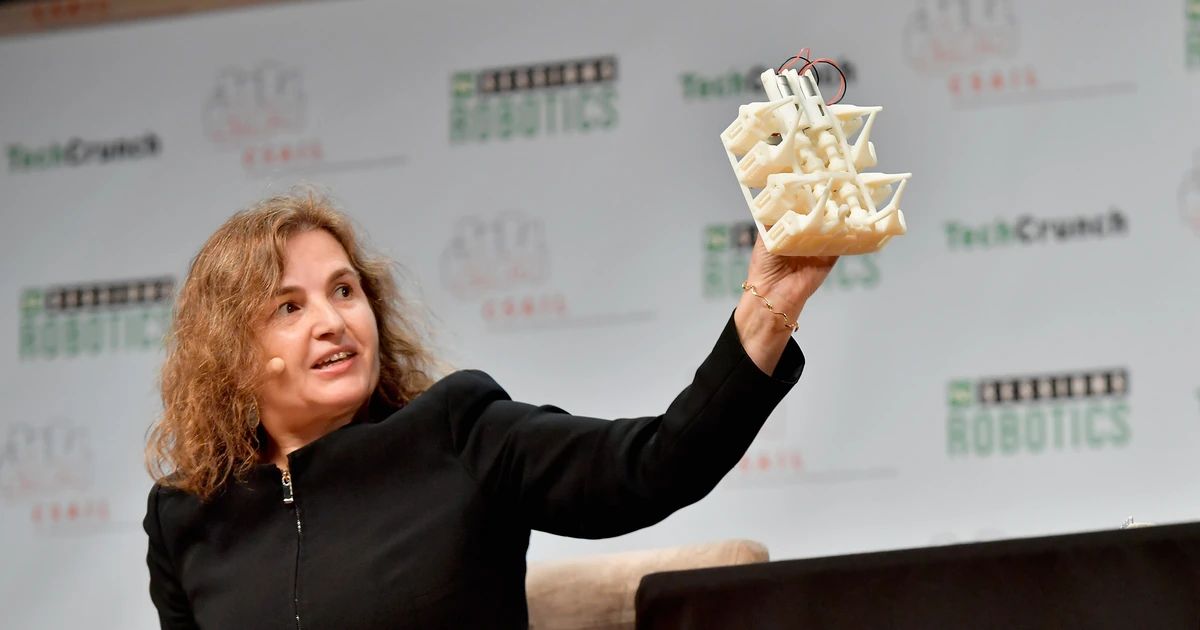
A Liquid AI anunciou em 22 de outubro o RIPL, motor de execução para seus Liquid Foundation Models. O anúncio oficial cita buscas e recomendações de produtos como aplicações.
O produto atende implantações empresariais em GPUs NVIDIA. A empresa divulga respostas completas abaixo de 50 milissegundos e compara LFM/RIPL com Qwen/vLLM, combinações diferentes de modelos e motores. Os resultados são da fabricante.
A Shopify é citada como usuária de LFMs em produção, sem confirmação de uso do RIPL.
Modelo e forma de execução são escolhas distintas
A documentação atual da biblioteca Liquid separa famílias de modelos por entrada e saída. Há modelos de texto para conversa, chamadas de ferramentas, saída estruturada e classificação; modelos de visão e áudio atendem outros formatos. A página também reúne modelos de decisão voltados a classificação, encaminhamento e pontuação.
O guia recomenda escolher primeiro a família adequada à tarefa e depois o ambiente de execução. Para texto e visão, relaciona alternativas como Transformers, vLLM, SGLang, llama.cpp e MLX, enquanto outras famílias possuem suporte mais restrito.
Essa documentação descreve o catálogo e caminhos de implantação. Não apresenta esses ambientes como um lançamento do RIPL nem garante que a mesma configuração sirva para qualquer modelo ou equipamento.
Como interpretar o ganho para aplicações de comércio
Na avaliação editorial da Nextags, o interesse para equipes de comércio está em reduzir a espera dentro de uma interação: uma busca de produto exige um ritmo diferente da elaboração de um relatório longo. Ainda assim, uma medição de execução do modelo não resume a experiência inteira do consumidor.
Uma avaliação prática precisa definir a tarefa, o volume de solicitações e a qualidade esperada da resposta. Também deve considerar o tempo gasto nas demais etapas da aplicação, como consulta ao catálogo e entrega do resultado à tela.
As comparações divulgadas trocam mais de um componente ao mesmo tempo. Por isso, não permitem atribuir a diferença inteira apenas ao motor de execução. Para uma operação de marketing ou vendas, o anúncio oferece uma opção de infraestrutura a investigar; ganhos de conversão ou economia exigem evidências específicas da aplicação. O critério final deve combinar tempo de resposta, erros observados e custo de operação.
Fontes e referências
As informações foram verificadas nas fontes abaixo. Novos fatos podem atualizar esta notícia.
- Liquid AI — anúncio do RIPL, 22 de outubro de 2026 ↗
- Liquid Docs — biblioteca de modelos e caminhos de execução, contexto técnico ↗
- Liquid AI — equipe e cofundadores, identificação de Daniela Rus ↗
- Fotografia original — Paul Marotta/Getty Images para TechCrunch, 17/7/2017 ↗
- Licença da fotografia — CC BY 2.0 ↗
Conteúdo de Angelo Sebastião Silva Goncalves. Preparado com apoio de IA. Consulte as fontes e os critérios editoriais. Conheça nossos critérios editoriais e como solicitar uma correção.