
O Ollama publicou em 24 de outubro de 2026 a versão 0.40.11, que acrescenta um catálogo de vozes ao Phonon e melhora a preparação de textos para leitura em voz alta. O lançamento é estável e reúne seis alterações desde a versão anterior. Fontes: lançamento e comparação entre versões.
Catálogo de vozes e ajustes na fala
A atualização permite importar as vozes fornecidas com o modelo e consultá-las pelo Ollama. Também ajusta a leitura de números, símbolos, endereços de email e links. O pacote inclui correções para a integração com OpenCode, o processamento de chamadas de ferramentas do Qwen3-Coder e solicitações com estado vazio nos modelos d3, além da atualização do componente llama.cpp.
Como funciona a geração de áudio
O Phonon utiliza um modelo de 31 milhões de parâmetros da Gradium, com vozes em inglês, como Zoey, Easton e Freya. A documentação explica que o som pode começar a tocar antes de a geração terminar. Também é possível gravar a saída em arquivo ou recebê-la pela API. Fonte: documentação de voz.
O limite de entrada é de 4.096 caracteres por requisição; no terminal, o programa divide textos maiores em parágrafos e frases. Os formatos previstos são WAV e PCM, com áudio mono de 24 kHz. Datas numéricas e horários continuam sendo lidos como escritos, o que exige cuidado na preparação do texto. A documentação já indica suporte à fala desde a versão 0.40.9; a 0.40.11 amplia o catálogo e modifica o tratamento da leitura.
Modelos de decisão têm outra função
O anúncio também destaca a família d3, destinada a classificar informações e atribuir pontuações a alternativas fornecidas pelo usuário. Ela recebe texto, dados estruturados ou imagens estáticas. A página do modelo ressalva que vídeos não são aceitos e que as probabilidades produzidas não são garantias de frequência no mundo real. Fonte: descrição do d3.
Esses modelos não escrevem uma resposta de conversa. A documentação também já os vincula ao Ollama 0.40.9 ou posterior, portanto sua presença nas notas atuais não estabelece que foram criados nessa atualização.
O que muda para quem automatiza conteúdo
Na análise da Nextags, um catálogo consultável de vozes facilita manter escolhas consistentes entre tarefas de áudio. A preparação de números e endereços também merece atenção em roteiros: uma mensagem pode estar correta por escrito e continuar pouco clara quando ouvida.
Antes de incorporar uma etapa de fala a um atendimento ou a uma produção de conteúdo, a equipe precisa ouvir exemplos representativos, revisar nomes próprios e decidir quem aprova o resultado. Para decisões automatizadas, convém definir critérios objetivos e prever revisão humana quando a classificação afetar uma pessoa. A escolha do modelo continua dependendo da tarefa e dos recursos disponíveis.
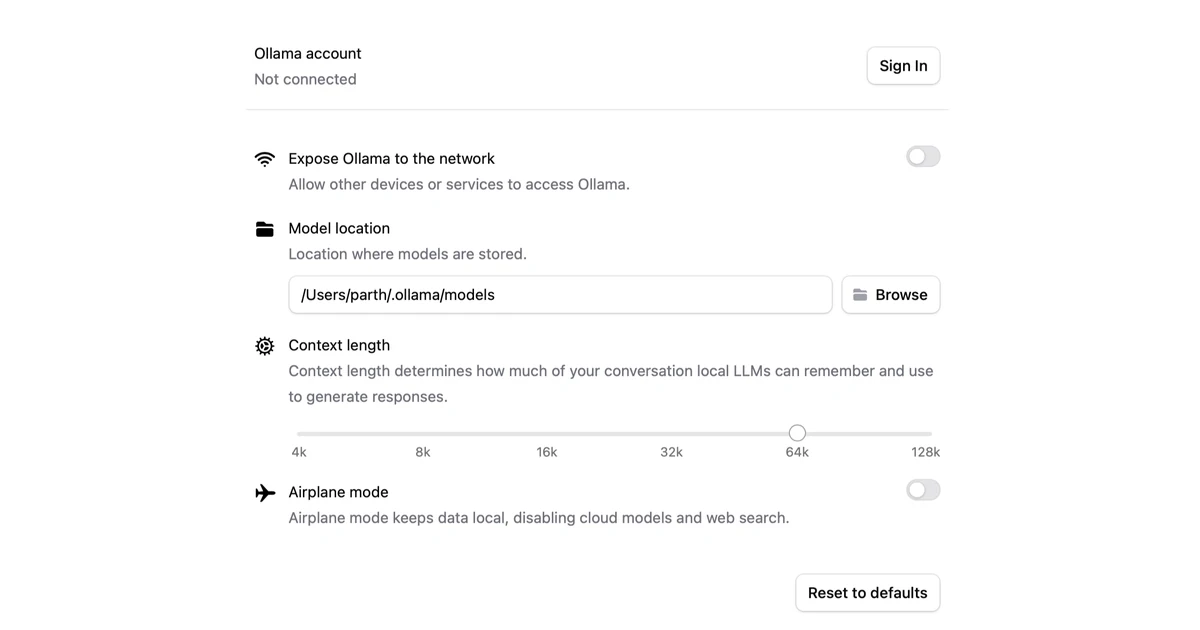
Configurações do Ollama em captura real da documentação, arquivo incorporado em 28/10/2025. Crédito: Ollama, licença MIT. Recorte da janela, redimensionamento, margens e conversão WebP. Arquivo original · Licença e copyright.
Fontes e referências
As informações foram verificadas nas fontes abaixo. Novos fatos podem atualizar esta notícia.
Conteúdo de Angelo Sebastião Silva Goncalves. Preparado com apoio de IA. Consulte as fontes e os critérios editoriais. Conheça nossos critérios editoriais e como solicitar uma correção.